Prompt Engineering:我会怎样把任务交给模型
延伸阅读:从 Prompt 到 Harness:我对 Agent 工程的理解
每次看到一长串提示词方法,我首先想知道的都是同一件事:它解决了什么问题?是让我把需求说得更清楚,帮助模型处理复杂任务,还是让我更容易发现答案里的错误?
如果这些问题没有分开,提示词就容易越写越长:既要求模型扮演专家,又要求分步思考,再让它自我检查五次。最后得到的回答看上去很有条理,却未必更准确。
下面这些方法可以放进这个顺序里看,但它们不是互相排斥的十种选项。示例、角色、问题分解、多次采样和事实核验,改变的是不同环节,可以组合使用。
一、先把任务说明白
1. Zero-shot:不给示范,直接交代任务
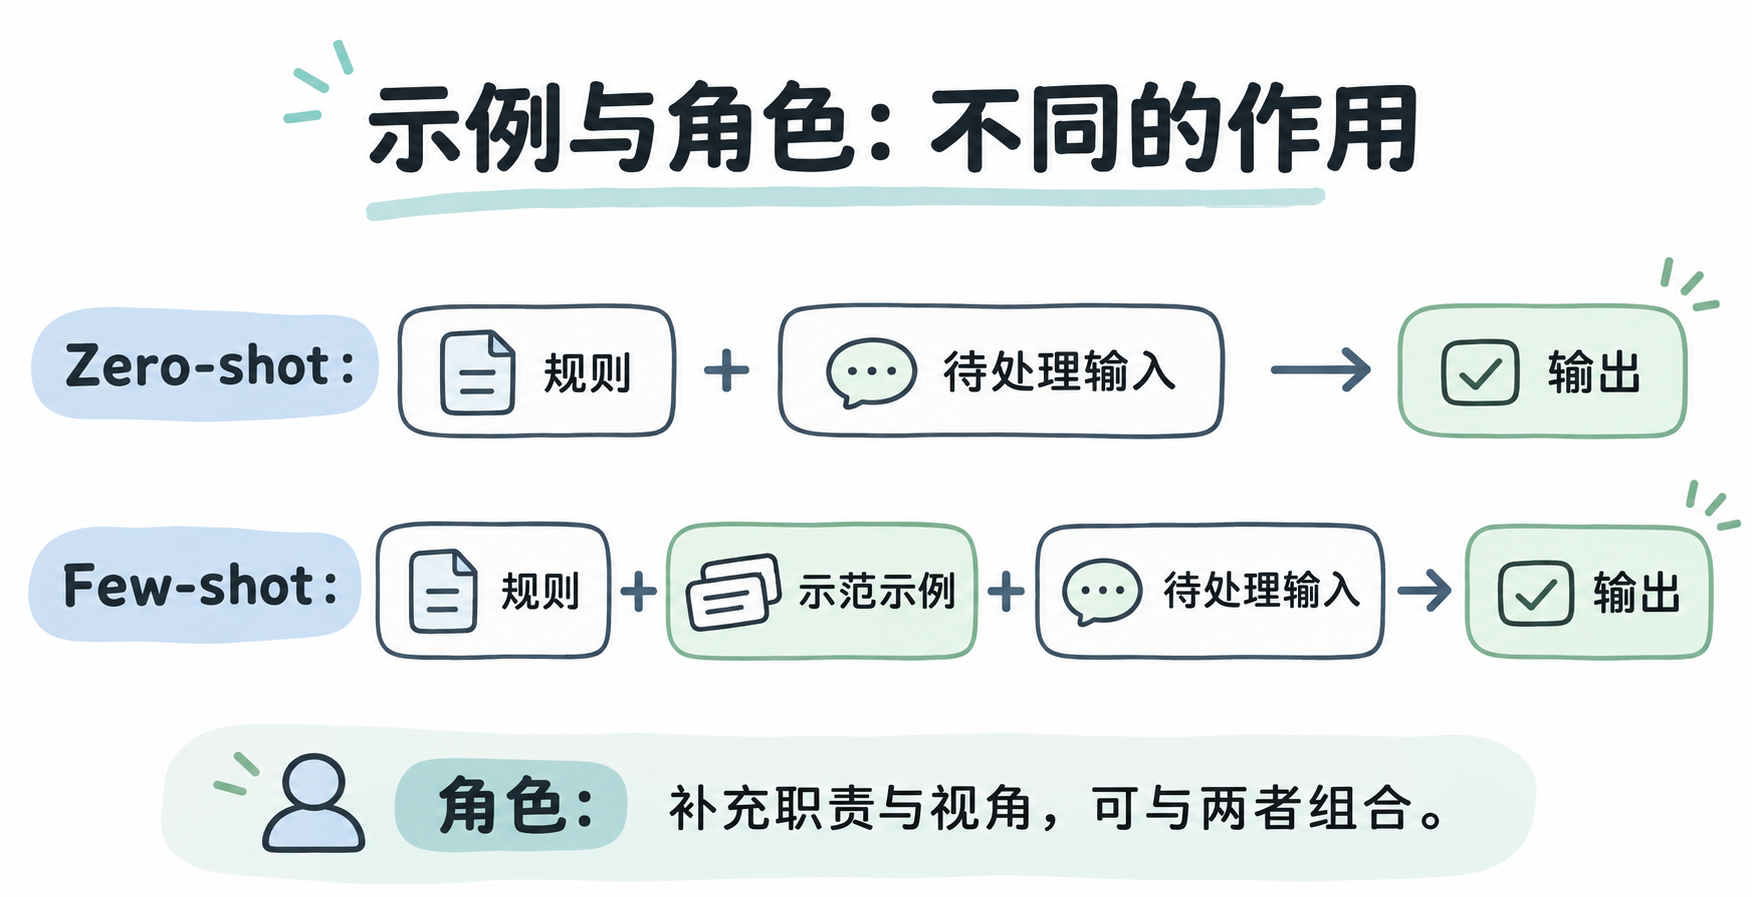
Zero-shot 指的是不提供任务示例,直接让模型完成任务。没有示例,不等于没有背景和约束,也不等于只能写一句话。
比如,我想把产品更新记录整理成面向普通用户的说明:
提示词:
请把下面的产品更新记录改写成一段面向普通用户的更新说明,控制在120至180字。

读者不需要了解技术实现。请说清楚增加了什么、用户能用它做什么,以及有什么使用限制。

只使用材料里已有的信息,不要把“测试中”改成“已经正式上线”。用一个短标题和一段正文输出。

更新记录:知识库新增批量导入功能,支持一次上传最多20个 Markdown 文件,单个文件上限为5MB。导入后可以在文件列表查看处理状态。PDF 批量导入仍在测试中,暂未开放。
这个提示词没有给模型看正确答案,却交代了读者、材料、限制和交付形式。对要求比较明确的改写、摘要、分类和信息提取,这通常是值得先试的起点。
2. Few-shot:用示范说明判断标准
有些要求用规则说起来很简单,执行时却容易出现分歧。比如,用户说“找不到按钮”,是在报告功能故障,还是反馈使用困惑?
Few-shot 的做法是在提示词里提供少量输入与期望输出,让模型从例子中理解任务口径和格式。
提示词:
请将用户反馈分为三类,每条只选一类:功能故障、使用困惑、功能建议。

参考示例:

输入:点了三次导出,页面都没有反应。
输出:功能故障|导出操作没有执行。

输入:我知道能导出,但没找到导出按钮。
输出:使用困惑|不知道导出入口在哪里。

输入:希望以后可以直接导出成 Word 文件。
输出:功能建议|希望增加新的导出格式。

请按相同格式处理:
1. 能不能支持两个人一起编辑?
2. 每次上传第二个文件,页面就卡住。
3. 标签已经建好了,但我不知道怎么给文章添加标签。
这里,例子的作用不只是规定输出格式,还展示了“功能故障”和“使用困惑”的区别。
我会优先选择能体现边界的例子,而不是堆很多简单样本。Zero-shot 和 Few-shot 最直接的区别,就是有没有提供示范。任务可以靠清楚的规则完成时,不一定非要加例子。
3. Role:给模型明确的职责和视角
角色提示经常被写成“你是一位世界顶级专家”。我更关心这个角色具体要做什么、关注什么,以及交付什么。
比如,我需要审阅一篇技术文章的大纲:
提示词:
请从技术编辑的视角审阅下面的大纲。文章面向没有机器学习背景的产品经理,目标是帮助他们理解 RAG 适合解决什么问题。

请检查概念是否准确,找出读者可能误解的地方,并检查内容顺序是否符合初学者的理解过程。给出具体修改建议,不要直接重写全文。

文章大纲:
一、RAG 就是给大模型增加记忆。
二、把公司的所有文件放进去,模型就能回答所有业务问题。
三、RAG 可以彻底解决幻觉。
四、如何选择向量数据库。

请按“原表述、问题、建议修改”逐条输出,最后给出一版不超过五项的新大纲。
这个角色有明确的审阅对象和判断标准。相比单纯加上“资深”或“顶级”,具体职责更容易转化成实际行为。
二、遇到复杂问题,怎么组织处理过程
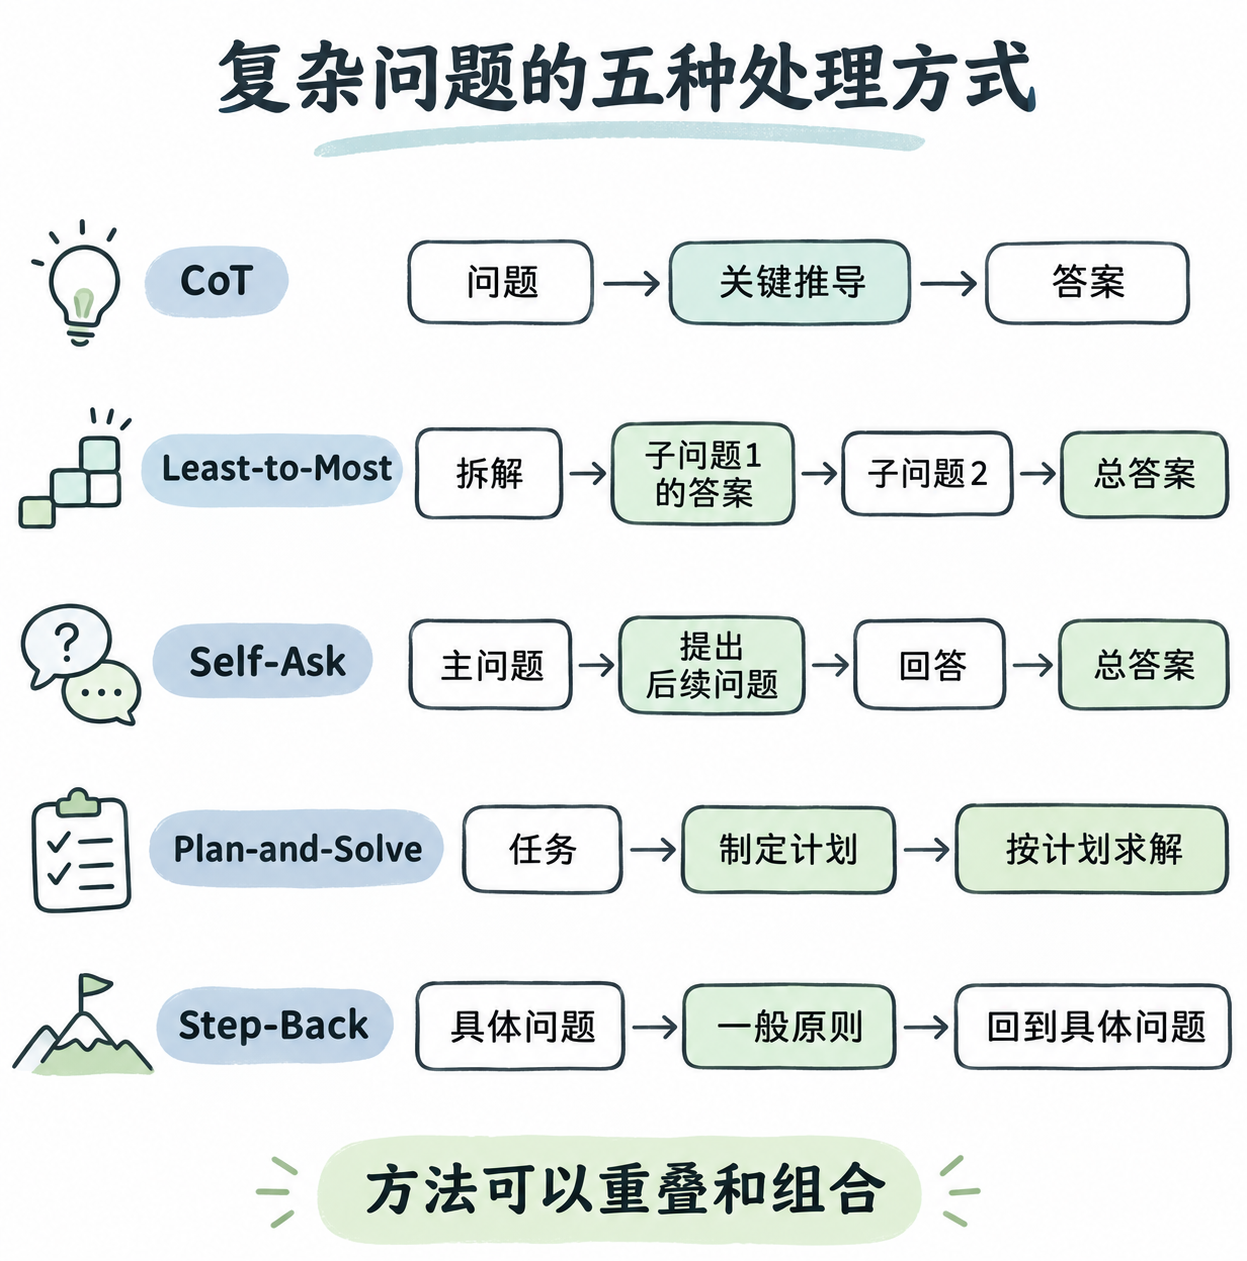
接下来的方法都涉及“怎样处理问题”,但针对的难点不同:有的需要推导,有的存在前置依赖,有的缺少事实,还有的需要先安排工作顺序。
4. Chain-of-Thought:让关键推导可以被检查
Chain-of-Thought,通常简称 CoT。经典做法之一是在示例中展示中间推导,再让模型按照类似方式解决新问题;也可以不提供推导示例,直接引导模型分步处理。
例如:
提示词:
请计算活动的净收入,并用简短、可核对的算式说明结果。

参考示例:10人参加活动,每人支付100元。支付平台按实收金额收取2%的手续费,场地成本为300元。

解答:收入为10×100=1000元;手续费为1000×2%=20元;净收入为1000-20-300=680元。

现在计算:一场活动共有40人付款,其中12人购买160元的早鸟票,另外28人购买200元的普通票。支付平台按全部票款收取2%的手续费,场地和物料成本合计1800元。没有其他收入、退款或支出。

请输出总票款、手续费、净收入及对应算式,金额保留两位小数。对当前的推理模型,我不会把“逐字展示全部思考过程”当成通用要求。更实用的是要求关键步骤、必要假设、公式和可检查的依据。推导写得完整也不代表一定正确,计算任务能用计算器或代码时,仍然应该核对。
5. Least-to-Most:先解决后面会用到的子问题
Least-to-Most 的重点是把复杂问题拆成更简单的子问题,再按依赖关系逐个解决。前面的答案会成为后续求解的条件。
比如,我想向初学者解释“为什么 RAG 能减少某些事实性错误,却不能保证回答完全正确”。可以分轮进行:
第一轮提示词:
我想向没有机器学习背景的读者解释:为什么 RAG 可以减少某些事实性错误,却仍然不能保证回答完全正确?

请先不要回答总问题。把它拆成3至4个有依赖关系的子问题,按适合初学者理解的顺序排列。后一个子问题应当用到前一个子问题的答案,并用一句话说明为什么需要先解决它。
接下来逐轮提示:
请回答下一个尚未回答的子问题,并明确用到前面已经建立的结论。如果前面的结论有不足,请先修正。暂时不要提前回答后续问题。最后提示:
请结合前面已经建立的结论,回答最初的总问题。保留必要的因果关系,不要机械拼接前面的回答。例如,可以先解释“检索到的资料如何进入模型的回答过程”,再利用这一结论分析“资料缺失或错误时会怎样影响回答”,最后据此说明“为什么引入检索仍不能保证事实准确”。后一步要明确引用并使用前一步建立的结论,而不是分别回答几个互不相关的问题。
这里重要的是“拆解、逐个解决、传递结果”。它可以在一次回答里轻量完成;依赖关系重要时,分轮处理更容易检查和纠正。
6. Self-Ask:先问清楚还缺哪些事实
Self-Ask 会先提出回答主问题需要的后续问题,再回答这些问题,最后形成结论。它可以结合检索,但检索不是必需条件。
例如:
提示词:
请回答:《百年孤独》首次出版,与作者获得诺贝尔文学奖,相隔多少年?

回答前,先识别需要查明的中间事实,逐项提出后续问题。每回答一个问题,再判断是否还需要补充其他问题。

如果具备联网检索能力,请优先查阅可靠资料,并为关键年份提供来源链接。注意,不要把小说获奖与作者获奖混为一谈。

如果无法检索,请说明哪些事实尚未核实,不要编造来源。

最终输出必要的中间事实及来源、年份差的计算和一句话答案。
这里的“问”,主要是向任务提出后续问题,不是把所有问题反过来问用户。
Self-Ask 和 Least-to-Most 有交集,但关注点不同:Least-to-Most 强调从简单到复杂、利用前面的答案;Self-Ask 更强调回答主问题前还需要弄清哪些问题。如果缺少的事实仍然靠猜,拆得再漂亮也不等于可靠。
7. Plan-and-Solve:先制定计划,再按计划处理
Plan-and-Solve 强调先形成计划,再根据计划完成任务。它适合需要统筹顺序、资源和交付要求的情况。
提示词:
请分析一家网店同一广告活动最近四周的数据,判断后两周的变化,并给出有数据依据的结论。

以下数据均为同一统计口径,访问量、订单及销售收入均归因于该广告活动。订单不含退款,收入为可归因的实际销售收入,广告费为该活动支出:
第1周:访问量1000,订单50笔,收入10000元,广告费2000元。
第2周:访问量1200,订单72笔,收入14400元,广告费2400元。
第3周:访问量1500,订单60笔,收入12000元,广告费3000元。
第4周:访问量1600,订单64笔,收入12800元,广告费3200元。

第一阶段,先列出不超过五步的分析计划,说明准备计算哪些指标、如何比较前后两周,以及怎样核对结果。

第二阶段,不要停留在计划上。请立即按计划完成计算:逐周列出转化率(订单÷访问量)、客单价(收入÷订单)和广告支出回报率 ROAS(收入÷广告费);再分别汇总前两周、后两周和四周整体的数据与指标。汇总指标应使用合计值计算,不要直接平均各周的比率。

比较前后两周的访问量、订单、收入及转化率变化,用具体数字说明哪些指标变了、哪些没有变。转化率的差值用百分点表达;百分比和金额保留两位小数,ROAS 保留两位小数。

最后核对各周合计是否与四周总数一致,给出最多三条结论和两项需要补充的数据。不要把 ROAS 当成利润率,也不要仅凭这四周的数据断言广告费变化导致了转化率变化。输出必须同时包含简短计划、实际计算结果和结论。
这里的计划主要回答“先做什么、再做什么、怎样知道做完了”,随后还要真正完成计算和分析。它与 Least-to-Most 可能重叠,但不一定需要形成一串由前一个答案支撑后一个答案的子问题。计划和执行结果都要检查:只列出漂亮的步骤,却没有算出指标,仍然没有完成任务。
8. Step-Back:先找相关原则,再回到具体问题
有时候,问题的难点不是步骤太多,而是注意力过早落在某个具体选项上。Step-Back 会先退一步提出更一般的问题,再用得到的原则分析原问题。
提示词:
我在判断是否应该增加博客更新频率。

已知:过去四周,每篇文章平均曝光5000次、阅读1000次,读完率45%;最近四周,每篇文章平均曝光2500次、阅读500次,读完率46%。两个时期都保持每周发布两篇。目前没有其他数据。

请先暂时放下“要不要多发文章”这个选项,回答一个更一般的问题:评估内容表现时,应该怎样区分曝光、点击和阅读质量?

提炼最多三条适用的分析原则,再回到上述数据,说明:数据直接支持什么判断、哪些判断没有证据、下一步最值得补充哪两项信息,以及目前是否足以建议增加更新频率。

不要把相关关系直接写成因果关系。
这个方法多了一次抽象,但最终要回到具体问题。如果模型只说“内容质量很重要”,却没有据此解释数据,那么退后的这一步就没有发挥作用。
三、让结果更值得信任
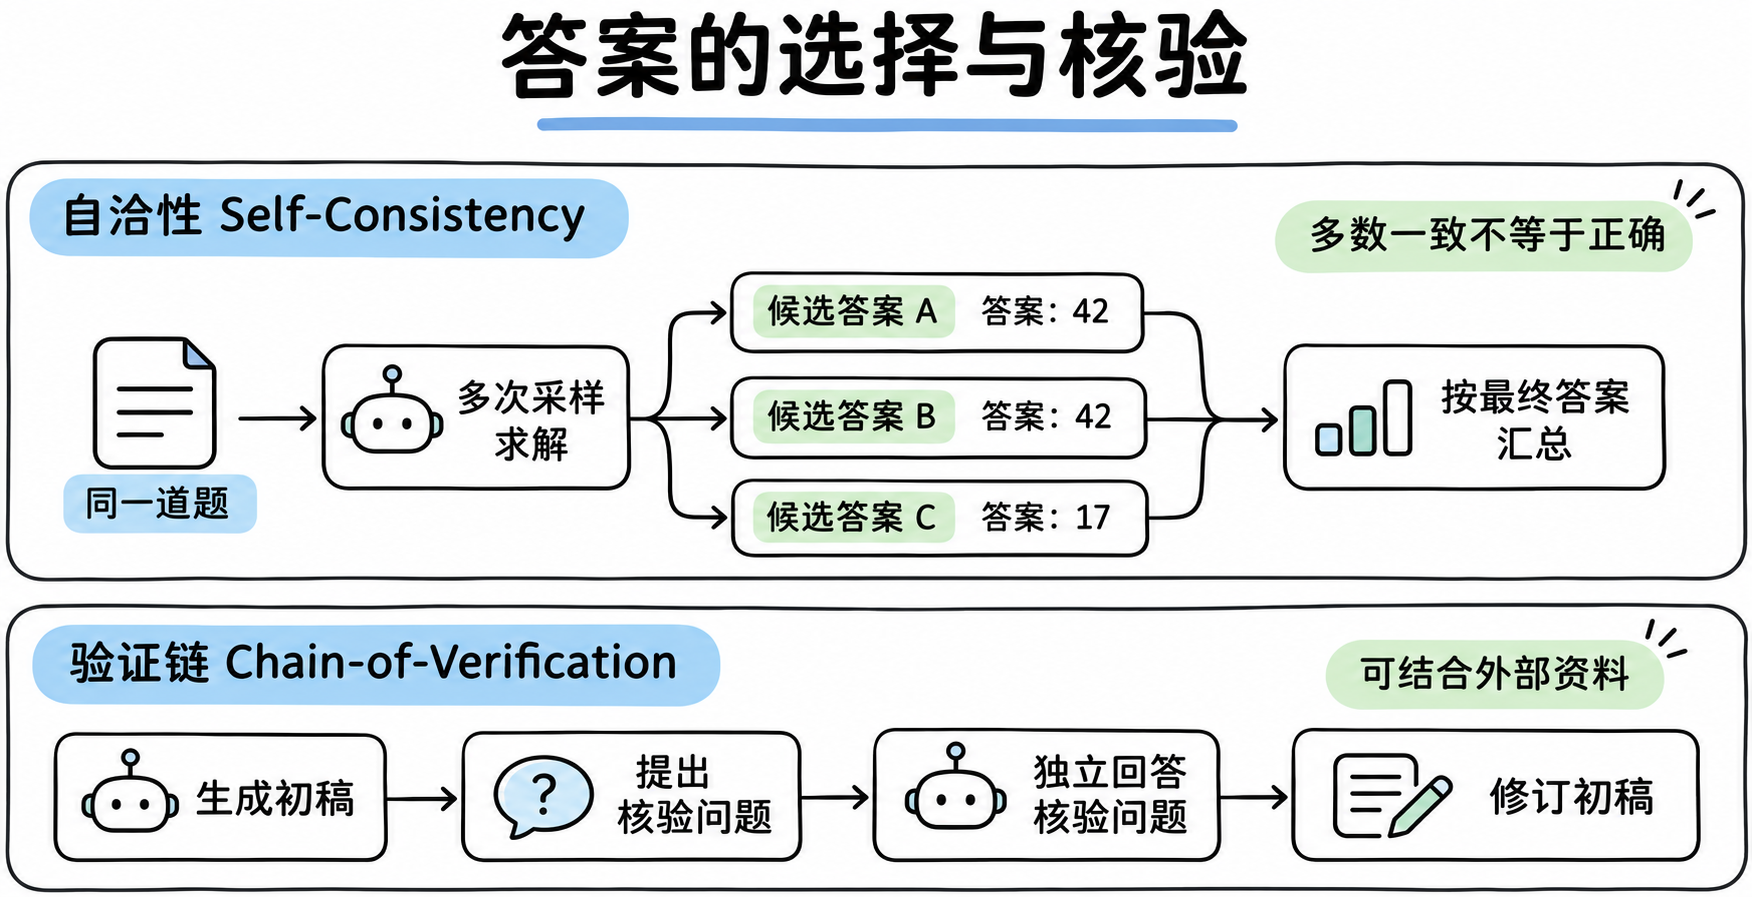
前面的方法主要帮助模型理解和处理任务。下面两种方法进一步关注候选答案和核验过程。
9. Self-Consistency:多次求解,再汇总答案
Self-Consistency 的典型做法是对同一个问题采样多条推理路径,再按最终答案的一致性进行汇总,常见方式是选择出现最多的答案。
关键在于产生多个候选。在同一条回答里让模型“想出五种思路再投票”,不等同于多次独立采样,因为后面的内容可能受到前面内容影响。
实际采样需要产生有差异的推理路径。机械重复完全确定性的调用,可能只会得到同一个结果,未必带来额外收益。
例如,把下面的提示词用于多次彼此不共享候选答案的调用:
独立求解提示词:
请计算这笔销售的净收入。

共有4箱商品,每箱12件,全部售出。每件标价18元,所有商品统一打九折。支付平台按折后实收金额收取5%的手续费。商品进货成本合计500元,没有其他收入、退款或支出。

净收入定义为:折后销售额减去手续费,再减去进货成本。

请返回最终金额和一行关键算式,金额保留两位小数。
取得候选后,再进行汇总。假设五次候选分别是238.72元、238.72元、277.60元、238.72元、238.72元,可以让模型按金额分组计数。这里的候选数字只是为了演示汇总方式,并不是一次实际测试记录。
Self-Consistency 更适合答案可以比较的任务,也会增加调用次数、时间和成本。
10. Chain-of-Verification:把待核实的内容拆成问题
Chain-of-Verification,简称 CoVe,通常包括四步:先生成初稿,再提出核验问题,随后回答这些问题,最后根据结果修订初稿。
重要的一点是让核验尽量不受初稿影响。如果只是问“你刚才说得对吗”,模型很容易继续认可自己原来的说法。
下面用一组虚构产品资料演示:
第一步,生成初稿:
请只依据以下资料,为笔记产品“青页”写一段120字以内的介绍。区分已经支持的功能与仍在测试的功能,不推测资料没有说明的内容。

资料A:2.0版本支持导入 Markdown 文件,支持 Windows 和 macOS。
资料B:多人协作正在内部测试,公开开放时间未定。
资料C:免费版最多建立3个知识库;专业版每月12元。
第二步,针对初稿提出问题:
请从刚才的草稿中提取需要核验的事实性断言,并改写成可以单独回答的问题。每个问题只核验一件事。重点检查支持的系统、导入格式、多人协作状态、免费版限制和专业版价格。这一轮只输出问题,不回答问题。第三步,独立核验。可以另开一个不包含初稿的会话,只提供原始资料和第二步产生的全部核验问题。下面的五个问题仅作示范,实际使用时应替换成完整问题清单,避免遗漏:
请仅依据下面的资料回答核验问题。没有依据的内容写“资料未说明”,每个答案标注资料编号。

资料A:2.0版本支持导入 Markdown 文件,支持 Windows 和 macOS。
资料B:多人协作正在内部测试,公开开放时间未定。
资料C:免费版最多建立3个知识库;专业版每月12元。

核验问题(实际使用时,在此粘贴第二步生成的全部问题):
示范:支持哪些操作系统?支持什么导入格式?多人协作是否已经公开开放?免费版上限是多少?专业版月费是多少?
第四步,把核验结果带回原对话:
请根据提供的独立核验结果修订最初的产品介绍。纠正不一致的表述,删除缺乏资料支持的内容,只输出修订后的介绍。这套流程把笼统的“检查答案”变成了可执行的核验问题。只核对给定材料,可以检查回答是否忠实于材料;如果要判断资料本身是否仍然准确,还需要查询可信、及时的来源。
四、实际使用时,我会怎样选择
我的选择顺序通常是:
-
先写清楚任务、材料、限制和交付标准,用简单版本建立起点。
-
如果判断口径或格式总有偏差,就补充有代表性的示例。
-
如果缺少明确视角,就补充职责和关注点。
-
如果任务复杂,先判断复杂在哪里:是需要推导、存在前后依赖、缺少事实、需要统筹计划,还是被某个具体选项限制了思路。
-
如果结果重要,就设计相应的检查:事实查来源,数字用工具计算,代码运行测试。需要时再加入多候选比较或独立核验。
最后,我会用一组代表真实需求的任务比较提示词,不只看回答是否顺眼,还看事实错误、遗漏、格式、耗时和成本。调整提示词用过的例子之外,也留一些没参与调整的任务来检查,避免只对熟悉的题目有效。
对我来说,Prompt Engineering 最有价值的部分,是把模糊的期待整理成明确的任务、合适的处理方式和可检查的结果。知道什么时候应该多给一个例子,什么时候应该先查一个事实,什么时候需要独立核验,也知道什么时候一段简短指令就已经够了。