MiniClaude:个人 Agent 早期版本学习笔记 · 4
04-Agent 架构与设计模式盲区梳理
一次 Run 里的 Agent 架构与设计模式
用户说“读一下项目配置,解释启动方式”。接下来是谁调用模型,谁执行 read_file,读不到文件时谁决定重试,终端又为什么能实时显示进度?把这些问题放进同一次 Run,原来分散的类、消息和设计模式就能接起来。
本文沿用 MiniClaude 早期 S0–S3 学习笔记的命名,重点是 一次 Run 如何完成,以及各层各管什么。旧笔记没有附可核验的 commit,所以保留文件和类型名作为历史线索,不再引用 loop.py#L80 这样的精确行号。下文短代码是解释性示例,不是某个当前仓库的逐行摘录。
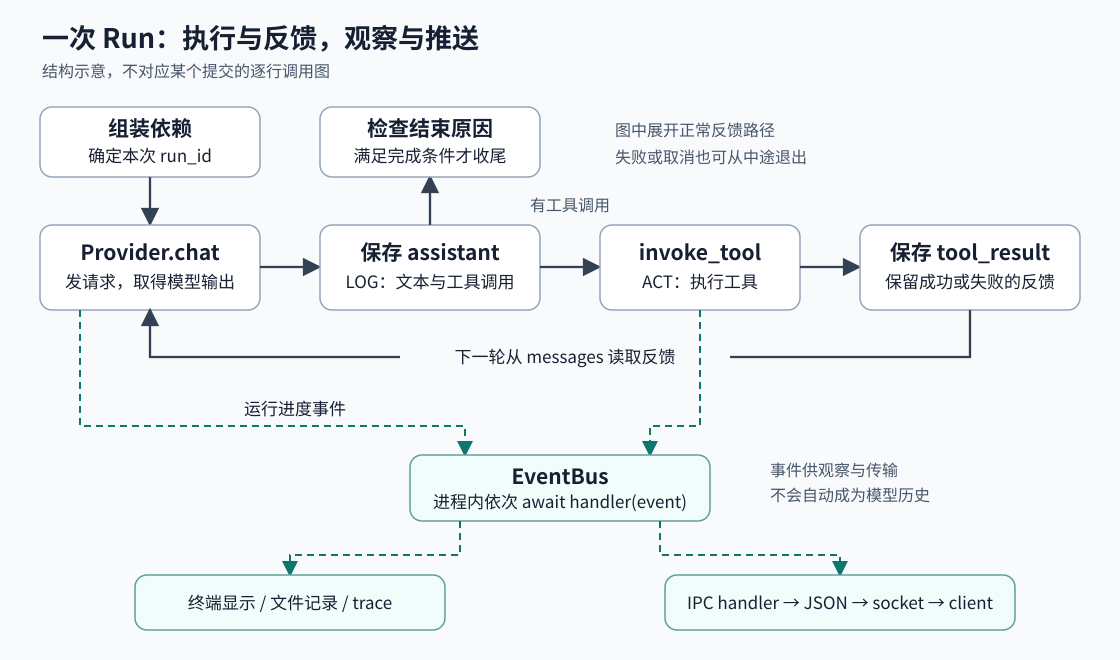
图中实线是执行与反馈路径,虚线是进度事件。模型的回复、工具的结果、给客户端的事件,是三种不同的数据。
1 开始 Run 时先把依赖装好
原笔记中的 runs.py 提供 new_run_id();直接运行的 runner 或 daemon 入口会生成 ID,再沿调用链传下去。关键是同一次 Run 复用同一个 ID,而不是每层各生成一次。历史格式类似 20260625-143045-a1b2c3:时间部分方便阅读,随机后缀降低碰撞概率,不等于数学上保证唯一。Run 相关事件、工具调用、trace、events.jsonl 和运行目录靠它关联。熟悉 Java 的话,可以把它理解成一次请求的 MDC traceId。
组装时需要四组东西:
Provider 可以替换 实现不能只看接口
原笔记里的 provider = self._provider or AnthropicProvider(model) 表示“传了就用传入的,否则建默认实现”。这是手动依赖注入:测试注入 MockProvider,正常运行用 AnthropicProvider,循环不用为此改一遍。
or 实际判断的是真假值,不仅是 None。如果约定只有 None 表示没传,更明确的写法是:
provider = supplied if supplied is not None else make_default_provider()
点进 LLMProvider.chat() 只看到 ...,通常是看到了 Protocol 声明,而非漏写了网络请求。原笔记的接口信息可以压成这一行:
# 接口示意;具体类型的定义在这里省略
async def chat(self, messages, tool_schemas, bus, run_id,
               *, step=0, system=None) -> LlmResponse: ...
messages 和 tool_schemas 是输入,bus/run_id/step 用来发布并关联进度,system 单独传系统指令;真正访问 Claude 的实现在 AnthropicProvider。
Protocol 支持结构化类型检查:对象具备约定的方法即可,不必显式继承它。ABC 配合抽象方法则能阻止未实现抽象方法的普通子类被实例化。原笔记以 LLMProvider 的 Protocol 和 BaseTool 的 ABC 对照;可以类比 Java 的 interface 与 abstract class,但别理解成 Python 的类型注解会自动完成运行时校验。Python Protocol · ABC
默认值和扩展点决定对象有没有误共享
extra_handlers 是给运行器加观察者的入口。旧笔记记录的 CLI 使用者是 StdoutPrinter.handle;以后也可以加别的 handler,不必改循环。
# 示例:允许不传;内部始终持有自己的列表
class RunnerOptions:
    def __init__(self, extra_handlers=None):
        self.extra_handlers = (
            [] if extra_handlers is None else list(extra_handlers)
        )
这里有两个问题:参数默认 None,避免普通函数的 =[] 在多次调用间共享;内部转换成列表,后面可以直接遍历订阅。原写法 extra_handlers or [] 也能兜底,但传入非空列表时仍共享那个列表;上例另外复制了外层容器。
消息历史则属于每个 context。普通函数的可变默认参数和 dataclass 要分开记:
from dataclasses import dataclass, field

@dataclass
class Context:
    messages: list = field(default_factory=list)

a, b = Context(), Context()
a.messages.append({"role": "user", "content": "读配置"})
assert b.messages == []
field() 是字段配置函数,default_factory=list 才指定了“每个实例新建列表”。若在 dataclass 中直接写 messages: list = [],类定义时会被拒绝,并不是一个能运行的“两个实例共享列表”演示。dataclasses 默认工厂与可变默认值
_build_registry() 把 ReadFileTool、BashTool、TaskCreateTool 等的创建和注册集中起来,解决的是同一个组装问题。叫它工厂函数就够了:只有“封装创建逻辑”,还不能证明它是 GoF 中把创建决定交给子类的 Factory Method。Factory Method 原始定义
2 第一轮请求先弄清模型看到了什么
模型不会拿到 Python 的工具实例。Provider 把工具名称、说明和 input_schema 交给模型;模型返回要调用哪个工具、带什么参数,再由程序执行。
用一组消息看清四层结构
下面是“读配置但路径写错”的协议示例。外层 messages 是列表,每条 message 是字典,content 可以是 block 列表,每个 block 再由 type 区分。
[
  {"role": "user", "content": "读一下 config.yaml"},
  {
    "role": "assistant",
    "content": [
      {"type": "text", "text": "我先读取配置。"},
      {
        "type": "tool_use",
        "id": "toolu_read_1",
        "name": "read_file",
        "input": {"path": "config.yaml"}
      }
    ]
  },
  {
    "role": "user",
    "content": [{
      "type": "tool_result",
      "tool_use_id": "toolu_read_1",
      "is_error": true,
      "content": "文件不存在:config.yaml"
    }]
  }
]
这一个例子覆盖了几个容易混淆的约定:
-
本篇关心
text、tool_use、tool_result三类 block,不是说 API 总共只有三类。块数组可以混合文本和多个工具调用,不必把它们拼成一句话。 -
普通自定义工具的
tool_use四个核心字段是type/id/name/input。其中id标识一次调用;返回时用tool_use_id配对,类似 RPC 的 correlation ID。它与标识整次运行的run_id不同。 -
tool_result放在user消息中是 Anthropic 的协议约定,既不表示用户亲自写了结果,也不表示结果成了更高权限的指令。角色由role决定,块类型由type决定,不能靠字符串还是列表来猜。 -
纯文本输入消息可以用字符串,它是单个 text block 的简写;并非只有 user 能这样写。含工具调用或结果时需要相应的 block 数组,API 返回的模型消息也以 block 数组组织。工具调用与结果格式 · SDK 消息参数定义
早期 MiniClaude 的这条路径在 messages 中使用 user/assistant,系统指令通过请求的顶层 system 参数传入。不要把“用户、模型、系统指令”三种职责,机械地写成这条路径里的三种 message role;其他接口和后续 API 功能也不能直接套用这里的约定。
一次回复有多个工具调用时,每个调用都要有对应结果,集中放进紧接着的 user 消息。工具结果应排在该消息的普通文本之前。这样合并有明确的工具协议依据;原笔记“任何连续 user 消息都非法”的解释过强,官方 SDK 文档说明相邻同角色输入会合并。也别把“一次返回多个调用”理解成程序已经并行执行了它们,执行顺序由应用决定。多工具结果规则
原生工具协议省掉了哪一层脆弱性
如果模型只输出 Action: read_file,程序还要解析自然语言约定;原生 tool_use 则给出明确的字段、参数 schema、多个调用的容器和结果配对 ID,模型也有对应的工具使用能力。这保留了 ReAct 中“决定行动再接收反馈”的思路,同时减少了靠正则拆文本的负担。
流式输出经过 SDK 但仍然是网络调用
原笔记的 Provider 路径是:发布模型选定事件,准备 system 和 tools,组装请求,读取文本增量,最后取得完整消息、用量和工具调用。
# Provider 内部示意;依赖由外部提供,省略事件的其他字段
async with client.messages.stream(**kwargs) as stream:
    text_parts = []
    async for chunk in stream.text_stream:
        text_parts.append(chunk)
        await bus.publish(LlmTokenEvent(run_id=run_id, token=chunk))
    final = await stream.get_final_message()

text = "".join(text_parts)
# tool_calls 应从 final.content 的结构化块提取,不从 text 中猜
text_stream 提供文本增量,每块不保证正好一个 token;LlmTokenEvent 这个历史名字不改变数据粒度。"".join(text_parts) 用空分隔符拼接文本;完整的 final 才包含结构化内容和 usage。SDK 还提供原始事件流,旧笔记这条路径没有直接消费它。流式消息与 SDK helper
进入流式请求时,SDK 负责 URL、headers、JSON 序列化、HTTPS POST 和 SSE 解析。直接使用 API key 时会用到 x-api-key、版本等请求头;“代码里没有 socket”不等于没有网络。它和 Java 中调用 HTTP 客户端的方法一样,把协议细节藏到了库里。Anthropic Python SDK
原笔记还记录了依赖分工:anthropic 用于模型访问,pydantic 用于事件等数据模型的校验与序列化,python-dotenv 加载 .env,另外列有 textual、httpx。这是该阶段记录的五项运行时依赖,不作为当前仓库的完整依赖审计。
缓存和浅拷贝在同一处相遇
多轮调用经常复用 tools 和 system,因此旧 Provider 在稳定前缀上放 cache_control。下面只改最后一个工具字典的顶层键:
def with_tool_cache(tool_schemas):
    tools = list(tool_schemas)       # 只复制外层列表
    if tools:
        last = dict(tools[-1])       # 再复制要修改的那个字典
        last["cache_control"] = {"type": "ephemeral"}
        tools[-1] = last
    return tools
如果省略 dict(),tools[-1]["cache_control"] = ... 改到的仍是原字典。list() 和 dict() 都是浅拷贝;上例没有改嵌套的 schema,所以这样已经足够。若要修改更深层的对象,要继续复制对应层,或按需要使用 copy.deepcopy(),不能把浅拷贝当深拷贝。Python 拷贝语义
缓存断点覆盖按 tools → system → messages 排列的提示词前缀,直到标记位置并包含该块;标记最后一个 tool,覆盖的是 tools 前缀,不会顺便缓存后面的 system。system 可以另设断点。默认 TTL 为 5 分钟,但还要满足最小长度、前缀一致性等条件;写入和读取均有计费,命中一般更便宜,不是免费,也不是固定只在第 2~5 轮有效。实际是否命中看 usage 中的缓存创建、读取 token 统计。提示词缓存
3 模型提出行动 工具把结果带回来
现在模型返回了 read_file 调用。旧笔记中 invoke_tool(registry, tool_call, bus, run_id) 的四个参数正好回答四个问题:
正常路径是查 registry、发布开始事件、调用 tool.invoke(input)、发布结束事件、返回结果。工具执行是 Act;结果进入上下文,才给下一轮提供 Observation。
# 循环示意;略去步数上限、结束原因判断和错误分支
response = await provider.chat(...)
context.add_assistant_message(response)     # LOG:保存模型的输出
for call in response.tool_calls:
    result = await invoke_tool(registry, call, bus, run_id)  # ACT
    context.add_tool_result(call.id, result)                # 保存观察结果
# 把更新后的 messages 交给下一轮模型调用
add_assistant_message() 记录“模型刚才说了什么、提出了什么调用”,并没有观察到工具的执行结果。旧笔记曾把它标成 Observe,这里改为 LOG。add_tool_result() 也不是凭空产生观察,而是把工具取得的反馈保存到下一轮能读到的位置。
ReAct 的重点是推理与行动交织,并根据环境反馈继续决定,而非必须实现一条叫 Plan → Act → Observe 的固定函数流水线。这里把模型决策简称 Plan,只是便于读代码;一次 Run 可以反复走这个回路。ReAct 论文
文件没找到 为什么还能继续
前面的示例返回 is_error: true 和“文件不存在”。模型下一轮可以先查目录、改路径,或说明无法完成。这是错误进入对话后提供了修复机会,不是模型一定会修好。
原笔记中,invocation.py 把一般执行异常经 _fail() 包装成 ToolResult(content=str(exc), is_error=True, error_type="runtime_error")。这里要分清内部结果对象与对外协议:error_type 可以供程序分类,Anthropic 的标准 tool_result 并没有因此自动多出这个字段。若需要模型也知道分类,应在转换时明确放进允许的内容中;仅有 str(exc) 也未必含异常类名。错误信息应具体、可操作,同时避免把密钥或无关敏感信息塞进历史。
4 运行中的事件走另一条路
模型能主动选 read_file,不能主动选 StdoutPrinter.handle。前者是 Tool,注册在 ToolRegistry,schema 会告诉模型;后者是 EventHandler,注册在 EventBus,由系统在发布事件时调用。可以把 Tool 想成工具箱里的扳手,把 handler 想成记录过程的摄像头。
下面就是进程内总线的核心:
class EventBus:
    def __init__(self):
        self._subscribers = []

    def subscribe(self, handler):
        self._subscribers.append(handler)

    async def publish(self, event):
        for handler in tuple(self._subscribers):  # 示例增加列表快照
            await handler(event)
列表保存函数引用,await handler(event) 是一次本地异步调用。它等待当前 handler 完成,才走到下一个;这里没有 broker,也没有自动排队或并发投递。慢 handler 会拖慢发布,handler 抛异常若不隔离,也会沿调用链影响发布方。
这就是 Observer/发布订阅在这个小系统里的用途:产生事件的地方不用知道终端、文件记录器分别是谁。它没有 Kafka 或 Redis Pub/Sub 的跨进程传输能力。原笔记的 daemon 另外订阅了 IPC broadcaster,把事件转成 JSON,再经 TCP socket 发给 client;进程内总线与跨进程通信是两层。
到客户端时 已经换成协议数据
原笔记中的推送封装可以表示为:
from typing import Any, Literal
from pydantic import BaseModel

class EventPushEnvelope(BaseModel):
    kind: Literal["event"] = "event"
    event: dict[str, Any]
kind 在这个定义中只有 "event",不是已经支持 error/system 等值的扩展列表;Pydantic 按该声明校验。event 是 Event.model_dump() 后的字典,再编码为 JSON 传输,不是把服务端的 Event 对象直接传过去。客户端 _dispatch 读到 kind == "event" 后,把这个字典交给回调。Pydantic Literal 校验
同一个项目在不同边界可以选择不同复杂度:历史记录中,内部事件种类较多,用 type 作 Pydantic 判别联合的 discriminator;JSON-RPC 响应主体主要区分 {id, result} 与 {id, error}(还带协议版本等字段),没有照搬那套事件联合。这个取舍不意味着 JSON-RPC 不能做联合类型,也不意味着事件 push 本身就是一次普通 RPC 响应。
多个 Run 共用总线 不等于所有状态都安全
S3 记录的结构是 CoreApp 把同一个 bus、trace 交给 SessionManager,由 SessionManager.send_message() 内部创建 AgentRunner;不要画成 CoreApp 为每次请求直接 new runner。每次 Run 的 context 与这些共享对象也要分开理解。
在同一事件循环内,一个 Task 的无挂起片段不会被另一个 Task 插入执行,但每次真正挂起的 await handler(event) 都可能让其他 Run 前进。上例快照只固定这一次遍历的订阅集合,没有让跨 await 的共享状态变成原子的。handler 还需按 run_id 过滤归属,跨 await 的读改写需检查一致性。
原笔记的 TraceWriter.emit() 用 put_nowait() 把记录放到共享 asyncio.Queue,适合在同一事件循环内协作;它不是线程安全队列,也不代表队列永远不会满。需要跨线程访问时不能直接套这条结论。asyncio 调度 · asyncio.Queue
5 用 trace 看见这次 Run 的来回
工具、总线解决“做事”和“通知”,trace 解决“事后知道走到了哪里”。TracingProvider 包住实际 provider,在调用前后补记录,再把结果原样交还给调用方:
调用路径是 AgentLoop → TracingProvider → AnthropicProvider → Claude API;响应沿反方向返回,包装层在委托前后记录。
这才是 Decorator 的识别点:调用契约保持一致,内部委托给 inner,外层添加能力。类似 Java 的 BufferedInputStream(new FileInputStream(...))。包装器必须保留 messages、tools、system、step 等参数语义,而不是只让两个方法碰巧同名。
原笔记的 TraceRecord 每行回答这些问题:
CLIENT→CORE + ipc 是收到客户端命令,CORE→LLM + llm 是发模型请求,LLM→CORE + llm 是模型响应,CORE + event 是内部事件,CORE→CLIENT + ipc + push 是主动推送。data 保留开放字典,是因为 IPC 关心方法名,LLM 关心用量与耗时,事件层关心事件内容,不必强塞一套空字段。
旧笔记里的 mini trace 会按 direction 彩色回放这些记录,例如客户端到核心用青色、核心到模型用紫色。理解它时可以借用“结构化日志加 MDC”的经验,不必把每条 trace 当成一种新消息协议。
同一事件完整记一次 推送再记摘要
CORE 事件记录保留完整 body;IPC push 记录只保留 sub_id + event_type 等摘要。若有三个订阅者,完整事件再随每次 push 重复写一遍,就会存四份相同载荷。日志总大小不一定恰好翻几倍,但重复开销很直接。
这两处分别回答“发生了什么”和“给哪个订阅者发过”。排查时可以按 run_id、事件类型和订阅者查推送路径,用时间戳估算两处埋点间的耗时。服务端记了 push,不等于客户端已经收到或渲染;同一 Run 同类型事件很多时,仅靠摘要也未必能一一配对,需要更多关联信息或客户端证据。这样才不会把可观测性写成投递保证。
记录完整输入输出 是单独的选择
原笔记中 trace: TraceWriter 决定记录交给谁写,include_payload 决定写多细:为 true 时包括完整 LLM 输入输出,为 false 时只留消息数、token 用量、延迟等摘要。
# 早期笔记记录的 ~/.mini/config.toml
[trace]
enabled = true
file = "~/.mini/traces/daemon.jsonl"
include_llm_payload = true
读取链路是 TraceConfig.include_llm_payload → TracingProvider(include_payload=...);历史配置优先级为默认值 True < config.toml < 环境变量,环境覆盖示例为 MINI_TRACE_INCLUDE_LLM_PAYLOAD=false。开关兼顾隐私与文件体积,类似日志详细度选择;但关闭 LLM payload 并不自动清理其他事件或错误记录里的敏感内容。
6 任务清单也通过工具进入这个回路
较长的任务里,模型可能先创建“找入口”“读配置”“总结启动方式”三项待办。S3 的 Task 系统因此从用户操作的命令集,转向 Agent 可用的外部化记忆:把待办、依赖、完成状态留到上下文之外,需要时再读。
调用链仍然是同一条:模型看到 task_create schema,依据 goal 和上下文提出参数;AgentLoop 识别到 stop_reason == "tool_use" 的这条路径后,经过 invoke_tool → TaskCreateTool.invoke → TaskManager.create;manager 写文件,工具把结果返回给模型。参数由模型在这一阶段生成,可能包含用户目标中的信息,并不是用户必须逐字段填写。LLM 不直接写任务文件,也不会自动看到整份存储文件;它看到的是工具返回的 JSON 内容。
创建工具的 schema 描述 subject、description、blocked_by 等输入;例如 subject 是字符串,blocked_by 是整数 ID 列表,subject 是必填项。原笔记记录的 Task 数据字段如下:
from dataclasses import dataclass
from typing import Literal

TaskStatus = Literal["pending", "in_progress", "completed"]

@dataclass
class Task:
    id: int
    subject: str
    description: str
    status: TaskStatus
    blocked_by: list[int]
    created_at: str
    updated_at: str
这些 dataclass 字段本身没有默认值;旧笔记的 from_dict 读取逻辑另对缺失 status、blocked_by 回退为 "pending"、[],不要把读取容错写成构造器默认值。Literal 在这里是类型提示,不会让普通 dataclass 自动拒绝非法状态;需要的运行时校验仍要另做。
建议性依赖给模型参考 不替它把关
A.blocked_by = [B, C] 表示建议先完成 B、C。按 S3 笔记的设计,即使依赖未完成,直接把 A 更新为 in_progress 也不会被系统拒绝。
这种选择保留了灵活性,例如模型可能已经从别处取得所需结果;代价是依赖关系没有强制执行。它不同于把依赖作为调度条件的工作流。原笔记“串行时最坏只是工具报错,只有并行才需要强制检查”的判断不成立:串行也可能写出错误结果或造成副作用。是否需要强约束,要看任务的后果与前置条件,不能只看并发数;模型自纠只是可能的补救。
规划还会在执行中改变。发现新前置任务 D,可以 add_blocked_by=[D],需要撤销时有 remove_blocked_by。历史表达式 list(set(old + added)) 先拼接、去重,再转回 list;它不承诺原有顺序。若希望列表顺序稳定,可以这样写:
old = [2, 3]
added = [3, 4]
blocked_by = list(dict.fromkeys(old + added))
assert blocked_by == [2, 3, 4]
去重只解决重复 ID,不自动证明依赖存在、没有环或已完成。
为什么 TaskManager 没有自己的事件流
旧设计里的 TaskManager 是同步、纯文件操作,没有 async,也不直接 publish TaskCreated 之类事件。它把“Agent 正在怎样安排工作”的认知状态,与 RunStarted、ToolCallStarted 等运行时事实分开,避免每次改待办都增加一类广播。
这是一种阶段性的简化,不是“认知状态永远不该被用户看见”的原则。任务工具的调用仍可以经过通用工具事件;只是 manager 不再发一套任务专用事件。同步文件读写也不会因为是内部状态就自动变成非阻塞,多 Run 共享同一存储时仍需考虑并发更新。
7 收尾时区分错误 取消和返回值
“读文件失败”“模型请求失败”“用户取消”都能打断当前一步,但不该走同一种控制流。
这是历史实现的分层策略,不是“所有模型错误都不可恢复、所有工具错误都可恢复”的通则。比如网络故障可能适合有限重试,工具若留下无法确认的副作用则不能盲目重试。分类要问:在哪层能判断后果、能否安全继续。
# 模型调用分支示意;必须放在循环内部
try:
    response = await provider.chat(...)
except asyncio.CancelledError:
    context.mark_failed("cancelled")
    raise
except Exception:
    context.mark_failed("llm_error")
    break
Python 的取消通常在协程下一次可取消的挂起点以 CancelledError 体现;现代 Python 中它继承 BaseException,一般的 except Exception 不会接住它。清理后重新抛出,是把取消交还给 runner 等上层的常规做法,不需要照搬 Java 的重设中断标志。asyncio 取消约定
Java 要分情况:阻塞方法抛 InterruptedException 时通常清除中断状态;能继续向上抛就传播异常,不能传播、却还要让上层感知时才恢复中断标志。不是每个 catch 都必须“先 interrupt 再 throw”。Java InterruptedException
run 不返回结果 仍然会等待执行
旧笔记的 run_and_capture() 执行并返回 RunOutcome(status, result),方便测试直接断言;生产调用方通过事件获得结果时,可用薄包装 run() 丢弃返回值:
async def run(self, goal, run_id=None) -> None:
    await self.run_and_capture(goal, run_id=run_id)
这两者都会执行任务,也都要等待内部执行结束。它们分开了“是否收取结果”的使用方式,不是严格的 Command–Query Separation:Query 应不改变可观察状态,而 run_and_capture() 仍有执行副作用。Java 的 Runnable 与 Callable 可以类比返回值差异,直接调用它们的方法也不会自动开后台线程。CQS 的含义
真正“先给客户端回 run_id,再让 Run 继续”的是更外层的调度。S3 笔记记录的形状是:
# 外层调度示意;running_runs 是保留任务引用的集合
run_task = asyncio.create_task(
    sessions.send_message(session_id, goal, run_id=run_id)
)
running_runs.add(run_task)
run_task.add_done_callback(running_runs.discard)
# 这里可先返回包含 run_id 的结果,不等待 run_task 完成
集合保留后台任务引用,完成回调把它移除;移除本身不等于已经观察了任务异常或做完退出清理。run() 的 await、外层的 create_task、最终结果的传递,读代码时要分别看。
回到这一次请求
“读配置”这次 Run 现在能完整走通:入口确定 run_id 并组装依赖;Provider 带历史和 schema 调模型;模型提出工具调用;程序执行,把成功或失败的结果放回历史;下一轮依据反馈继续。事件总线把过程交给观察者,trace 留下排查证据,Task 工具保存较长任务的计划;最后由明确的结束、失败或取消路径收尾。
设计模式可以沿这条路径复习:注入让 provider 可换,工厂函数集中组装工具,Observer分发运行事件,Decorator为模型调用加 trace。先说清每个对象解决的问题,再给它命名,比把所有创建函数都归为 Factory Method 更有用。
读完可以拿这六个问题检查自己:
- 模型的
tool_use.id与本次run_id各关联什么?为什么结果不是 assistant 的新一句话? add_assistant_message()和add_tool_result()分别让下一轮知道什么?- 一个 handler 很慢时,当前
publish()会怎样?跨进程推送又发生在哪层? - trace 有 push 记录,是否足以证明客户端收到?关掉 LLM payload 是否等于全链路脱敏?
- 待办被标为 in_progress,是否说明 blocked_by 都已满足?
- 为什么工具错误可以回到模型,取消却要向上传播?为什么
run()返回 None 仍不等于后台执行?
SocketClient、ContextVar、Future 等 IPC 与网络细节留到对应篇章。本篇只把它们与 Run 相接的边界讲清楚。
系列目录 · MiniClaude:个人 Agent 早期版本学习笔记
- 1
- 2
- 3
- 4
- 5
- 6