同一个工具调用,为什么有三种写法?
从一个读文件的例子,看懂 OpenAI Chat Completions、Responses 和 Anthropic Messages。
刚学 Agent 时,很容易被这几个名字绕晕:都是把问题发给大模型,怎么一会儿是 messages,一会儿是 input,工具结果还可能放进 user?
我们就用“读一个文件”这件事,把三种写法放在一起看。你会看到:问题相同,工具相同,主要区别是信息放在哪、用什么字段表示。
一、这三个名字分别是什么?
调用模型时,程序要按指定格式发送问题,再按指定格式读取回答。我们说的 API 接口,就是这套通信约定。OpenAI 提供 Chat Completions 和 Responses 两种接口,Anthropic 提供 Messages 接口。
二、同一个问题,先看请求怎么写
假设你对模型说:“请读取 README.md,告诉我项目怎么启动。”下面先看问题和指令怎么放。工具说明稍后再讲;模型名称需要换成实际使用的模型。这些片段不能直接拿来运行。
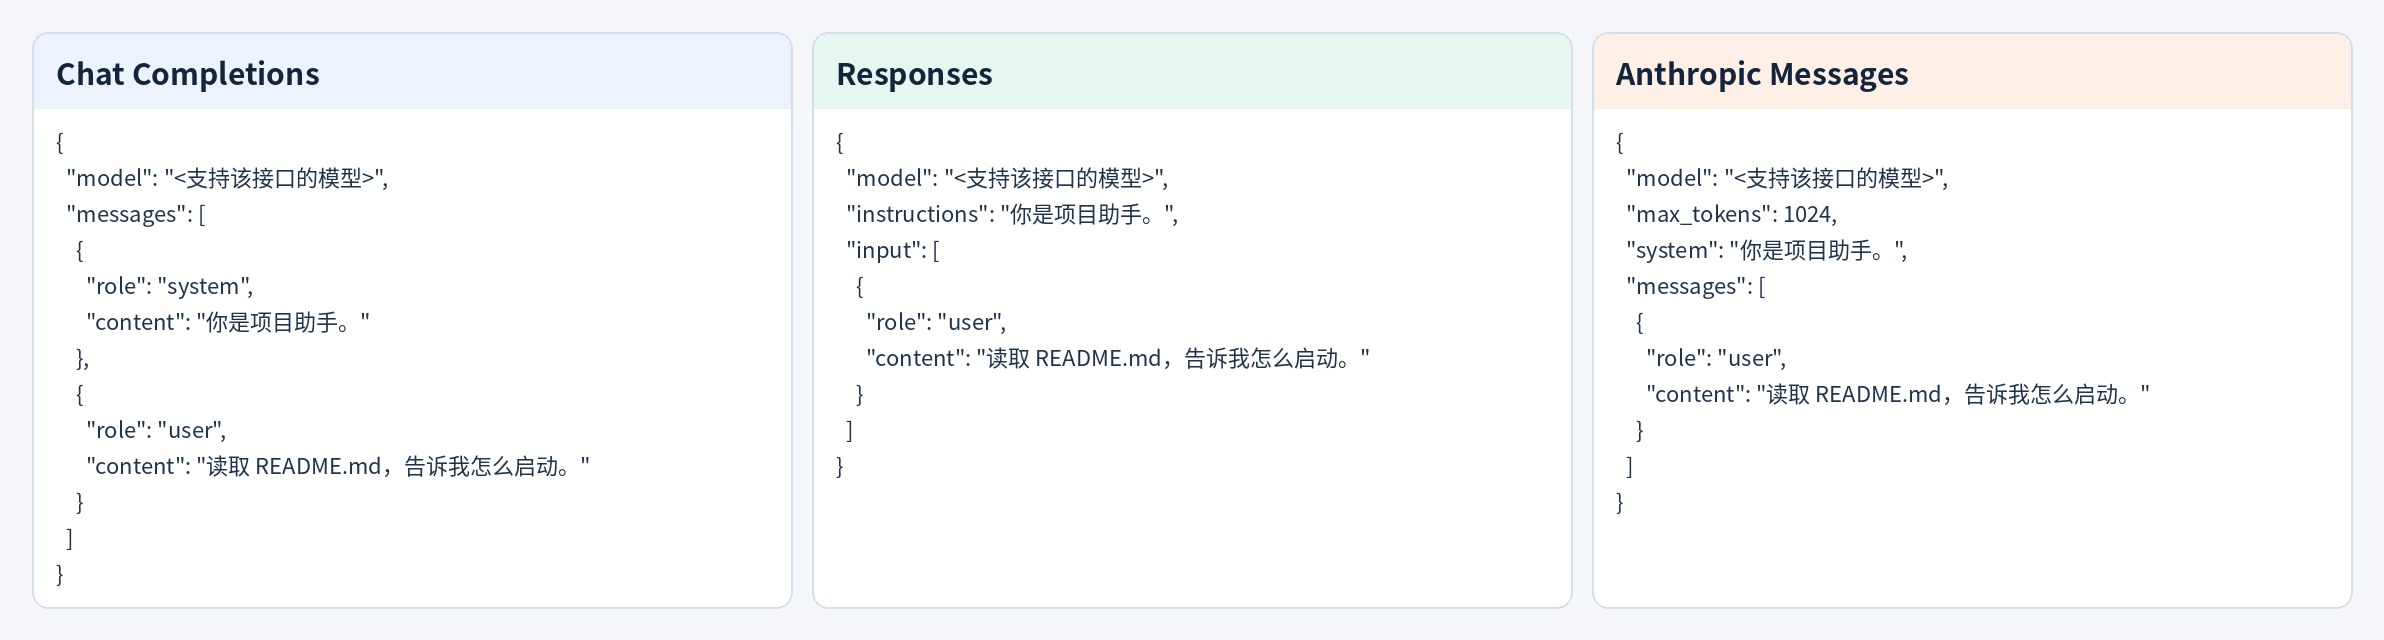
先找“你是项目助手”这句话。左边把它放进 messages 列表,中间放在 instructions,右边放在 system。同一句指令,在三种接口里放的位置不同。这里用常见写法演示;部分 OpenAI 模型使用 developer 角色,接入时看对应模型的要求。
接下来,程序要告诉模型有什么工具可用:“你可以用 read_file 读取文件,调用时要用 path 写清楚文件路径。”这些工具说明放在请求的 tools 列表里。
上表里的 parameters 和 input_schema 作用相同,都是用来写工具的参数要求:OpenAI 叫 parameters,Anthropic 叫 input_schema。比如:path 用来填写文件路径,值要是字符串,也就是文字。模型这次要读 README.md,就填 "path": "README.md"。这些参数要求按 JSON Schema 的格式来写。
三、模型要读文件:三种 JSON 放在一起看
下面上排是模型提出的调用,下排是程序读完文件后回传的结果。假设示例文件里写着启动命令 npm start。
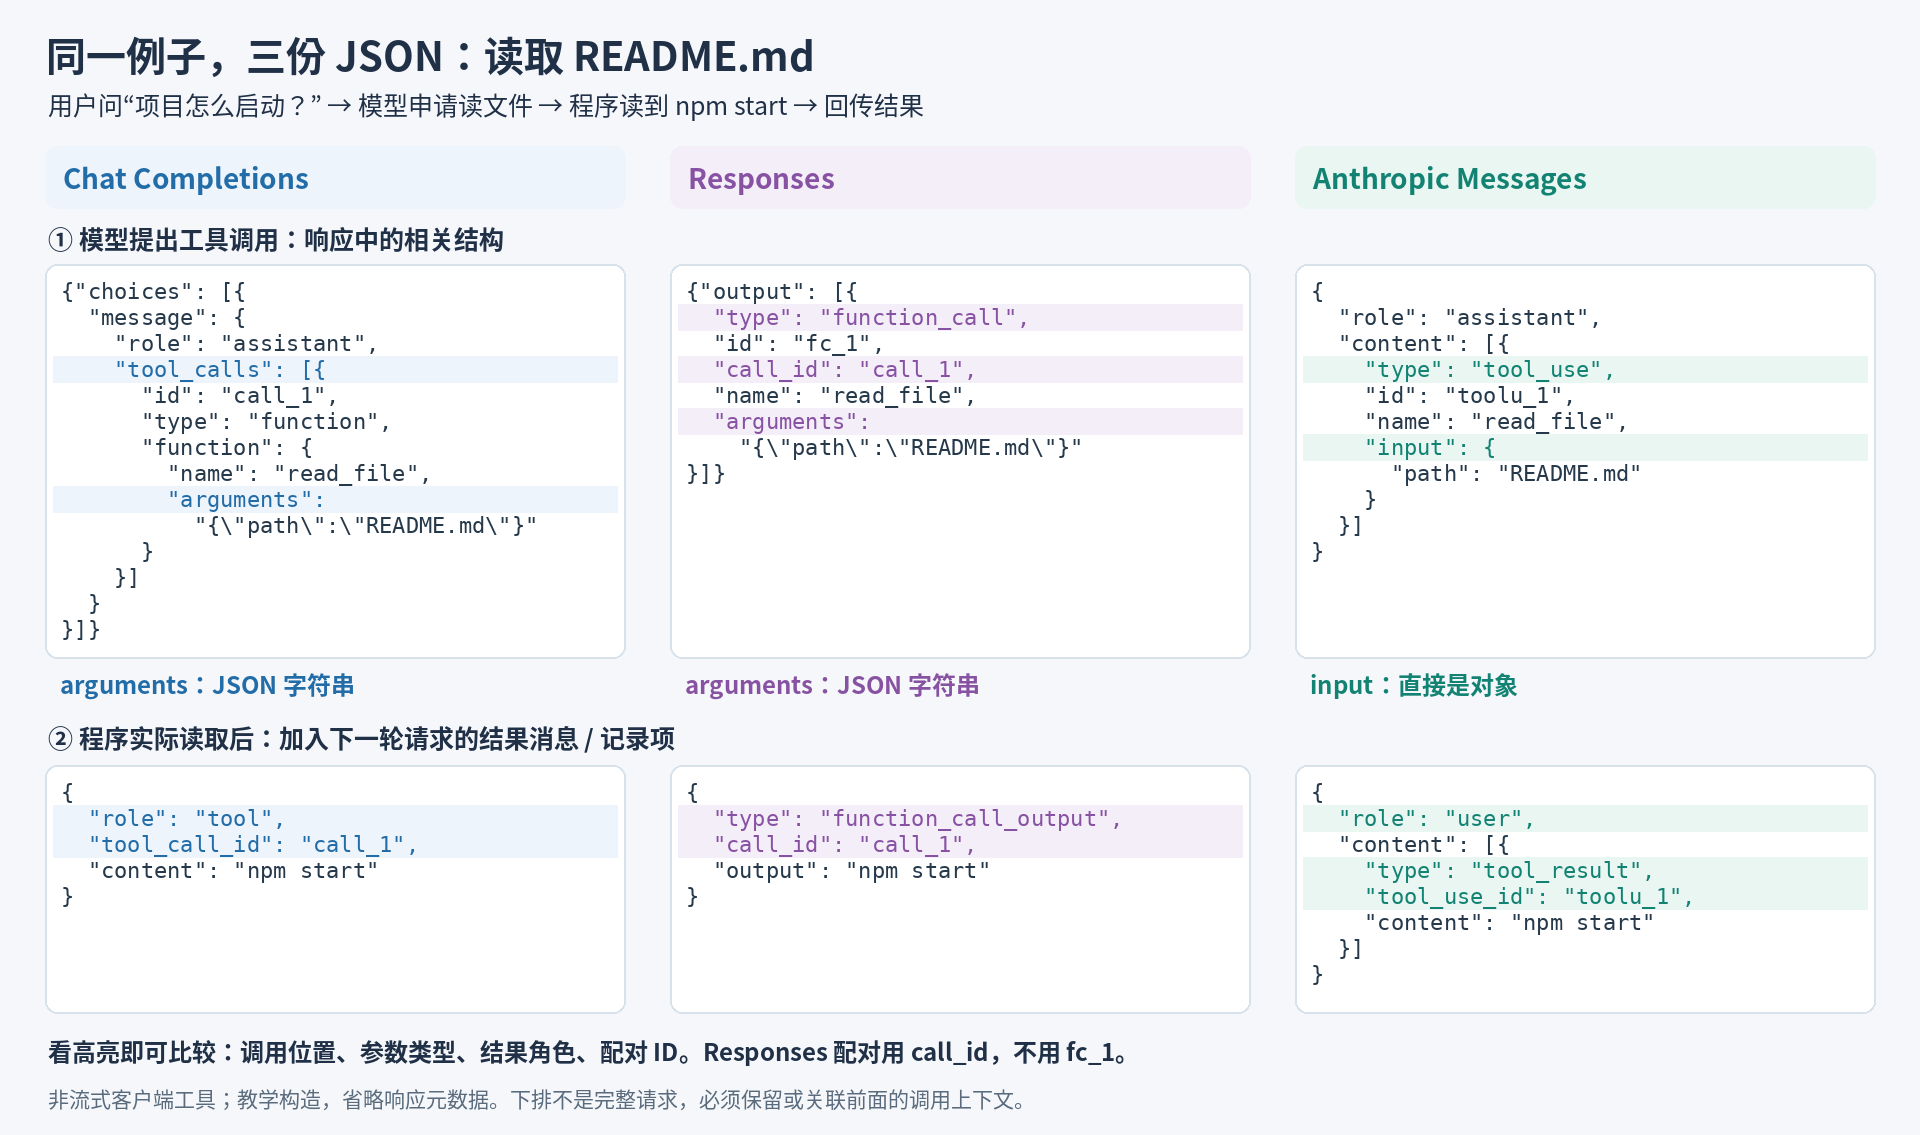
教学构造示例,并非实际运行记录。上排省略部分响应元数据;下排只是结果消息或条目,不是完整请求。
先看调用放在哪里:
- Chat Completions:助手消息里的
tool_calls。 - Responses:
output数组里一个类型为function_call的条目。 - Anthropic:助手消息的
content数组里一个类型为tool_use的块。
再看 README.md 外面那一层:前两列先把参数存成一段文字,放在 arguments 里。程序拿到后,要用 JSON 解析把它变成对象,才能取出 path。第三列的 input 已经是对象,可以直接取 path。前两列那些反斜杠,是为了在字符串里表示引号。
四、谁真的执行了工具?结果又怎么接回去?
模型提出调用 → 你的程序检查并读取文件 → 程序回传工具结果 → 模型继续回答
模型返回上面的 JSON,相当于说:“请帮我读一下 README.md。”你的程序检查这次调用后,才会真正打开文件。本文的 read_file 由自己的程序实现;厂商托管工具的执行方式另看对应文档。
读到 npm start 后,结果必须与之前那次调用配对:
每次工具调用都有一个编号。回传结果时带上这个编号,模型才知道“这是哪次调用的结果”。比如一次要读三个文件,就不能把三份结果对错。图中 Responses 有两个编号,回传时用 call_id: "call_1",不是 id: "fc_1"。
Anthropic 的写法容易让人困惑:明明是程序读到的内容,为什么放在 user 消息里?这是它规定的回传方式。里面的 type: "tool_result" 会说明:这一块是工具结果。
回传时,还得让模型知道前面发生了什么。Chat Completions 和 Anthropic 通常把问题、模型刚才的调用、工具结果一起带上。Responses 也可以这样自己保留历史,或者用 previous_response_id 引用上一次响应。选择引用时,本轮需要的 instructions 要重新提供。
五、模型最后回答了,去哪里取文字?
模型看到文件内容后,就可以回答:“项目通过 npm start 启动。”三种接口里的回答文字,分别从下面的位置取:
不过,模型也可能接着请求另一个工具。程序要先看返回的内容是什么类型,再决定显示文字还是继续执行工具。尤其是 Responses 的 output 和 Anthropic 的 content,第一项未必就是文字答案。
六、以后换成 Qwen,这些知识还用得上吗?
用得上。比如你把 Qwen 部署在支持 Chat Completions 接口的服务上,程序就能按这套格式发送 messages 和 tools。接口长得像 OpenAI,实际回答问题的模型是 Qwen;具体支持哪些功能,要看部署服务和模型版本。
程序发送接口 JSON → 服务解析请求,应用聊天模板 → 模型接收 token 并生成 → 服务解析生成结果,组装 API 响应
发给服务的 JSON,还要经过处理才能交给模型。其中的聊天模板(chat template),负责把“谁说了什么、有哪些工具”等信息,排成模型训练时熟悉的格式,再转换成 token。不同模型版本可能使用不同模板。
以后微调时,可以先准备这样的例子:用户要读什么文件、模型应该怎样提出调用、工具返回什么、模型最后怎样回答。然后按训练框架的要求保存,用对应模型的模板处理。还要设置哪些部分用来训练,比如是否只训练模型回答的部分。
API 返回的 usage(用量统计)、created(创建时间)等信息,通常不用作为对话答案让模型学习。等选定 Qwen 版本和训练框架,再确定具体的数据格式。
七、自己写 Harness,先接好这四步
前面负责发送请求、执行工具、回传结果的那部分程序,就是 Harness 的一部分。顺着这个例子,它做了四件事:组装请求 → 识别调用 → 检查并执行工具 → 按格式回传结果。
自己写时,先检查:能不能取出 path?结果有没有带对调用编号?文件不存在时,有没有如实返回错误?下一轮有没有带上前面的必要信息?最后再看,模型有没有根据读到的内容回答用户。
回头看那张三列图:都是“请读 README.md”,左边写在 tool_calls 里,中间是一条 function_call,右边是一块 tool_use。你先能顺着这个过程读懂 JSON,就已经抓住了这篇的重点。
延伸阅读
本文综合官方教程与对照文章整理。示例用于理解结构,未调用真实模型;实际接入以所选模型、服务及版本文档为准。